Wat er gebeurt in mijn AI-lab
Hallo lieve lotgenoten,
Vorige keer nam ik jullie mee in de wereld van AI-agenten: digitale assistenten die dingen voor je regelen terwijl jij toekijkt. Leuk speelgoed, en nuttig ook. Maar vandaag wil ik het over iets anders hebben. Over het werk waar ik het grootste deel van mijn dagen aan besteed, en waar tot nu toe weinig over te lezen viel op deze site: echt wetenschappelijk onderzoek om mensen met spraakproblemen te helpen.
Ik waarschuw jullie vast: er komt één stukje aan waar ik het over wiskunde heb. Ik heb geprobeerd het zo pijnloos mogelijk te maken. Als het te veel wordt, sla het gerust over en spring door naar het einde — daar staat namelijk een vraag aan jullie.
De Scott-Morgan Foundation: waar het begon
Om te beginnen bij het begin. De Scott-Morgan Foundation is een Britse stichting, opgericht door dr. Peter Scott-Morgan. Peter was robotwetenschapper en kreeg in 2017 ALS. Waar de meesten van ons vooral proberen te overleven, besloot Peter iets anders: hij zou zichzelf ombouwen tot cyborg. Hij noemde zichzelf “Peter 2.0”, liet zijn stem klonen, liet een avatar van zijn gezicht maken, en weigerde te accepteren dat een diagnose het einde van je leven betekent.
Zijn stelling was simpel en briljant: de beperkingen van een handicap zijn geen medisch probleem, maar een technisch probleem. En technische problemen kun je oplossen. Peter is in 2022 overleden, maar de stichting die zijn naam draagt gaat door met precies die missie. Ik ben er sinds enkele jaren aan verbonden als Technisch Onderzoeksleider.
De stichting werkt samen met een aantal grote namen: NVIDIA, Lenovo, ElevenLabs (van het stemklonen uit mijn eerste blog), D-ID voor avatars, en universiteiten in Mexico, België en Frankrijk. Het uitgangspunt dat mij het meest aanspreekt: ontwerpen mét mensen met een beperking, niet vóór hen. Dat klinkt als een marketingzin, maar het is het niet. Ik heb het hele systeem waar ik zo over vertel zelf gebouwd, met alleen mijn ogen.
SMF Labs en CANDOR: het onderzoeksdeel
Binnen de stichting is er een onderzoeksafdeling — informeel noemen we het SMF Labs. Daar draai ik mijn AI-lab: een klein internationaal clubje van onderzoekers, ingenieurs en studenten dat zich bezighoudt met de vraag hoe kunstmatige intelligentie mensen kan helpen die hun spraak verliezen.
Het onderzoeksprogramma heet CANDOR. Kort gezegd: we bouwen spraakherkenning die zich aanpast aan de individuele spreker in plaats van andersom. En we ontwikkelen manieren om spraakproblemen objectief te meten.
Waarom dat nodig is? Daarvoor moet ik even uitleggen wat er misgaat.
Waarom Siri je niet verstaat
Het medische woord voor onze spraakproblemen is dysartrie. Het betekent dat de spieren die je nodig hebt om te spreken — tong, lippen, gehemelte, stembanden, ademhaling — niet meer doen wat je hersenen vragen. Bij ALS, maar ook bij Parkinson, een beroerte, hersenletsel of cerebrale parese.
Nu het frustrerende. Alle spraakherkenning die je kent — Siri, Google Assistent, de dicteerfunctie van je telefoon — is getraind op miljoenen uren gezonde spraak. Nieuwslezers, audioboeken, podcasts. Als jouw uitspraak daarvan afwijkt, valt de herkenning volledig om. Niet een beetje slechter, maar helemaal stuk.
Het pijnlijke is: hoe meer je die technologie nodig hebt, hoe slechter hij voor je werkt. Precies omgekeerd aan hoe het zou moeten zijn.
En dan is er nog een tweede probleem, dat minder zichtbaar is maar minstens zo belangrijk. Als je logopedist of neuroloog wil beoordelen hoe erg je spraak achteruitgaat, gebeurt dat door te luisteren. Een deskundige luistert en geeft een oordeel: mild, matig, ernstig. Dat is vakwerk, maar het is subjectief, het kost tijd, en het kan alleen als je in de spreekkamer zit. Als jouw spraak in maart begint te veranderen en je afspraak is pas in mei, dan is er twee maanden lang niets gemeten.
Hoe je onderzoek doet met alleen je ogen
Even praktisch, want dit vragen mensen mij vaak. Hoe ziet mijn werkdag eruit?
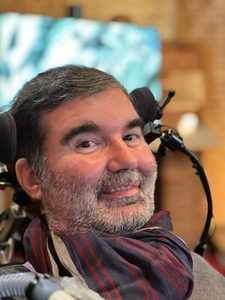
Ik zit in mijn rolstoel voor drie schermen. Mijn oogbesturing is mijn muis en toetsenbord. Ik schrijf geen code meer letter voor letter — dat zou onmenselijk traag zijn. In plaats daarvan werk ik met AI-agenten (zie de vorige blog) die ik opdrachten geef. Ik denk, zij typen. Ik controleer, zij corrigeren.
Een typische dag: ’s ochtends analyses draaien op de computerservers, resultaten bekijken, overleggen met mijn team in Mexico en Frankrijk, en ’s middags schrijven — code, artikelen, e-mails. Gemiddeld een uur of tien. Mijn vrouw vindt dat te veel. Ze heeft waarschijnlijk gelijk.
Het onderzoek zelf werkt zo: we verzamelen spraakopnames — van mensen met dysartrie én van gezonde sprekers — en laten AI-modellen daarnaar luisteren. Niet om te verstaan wát er gezegd wordt, maar om te meten hóe het gezegd wordt. Daar zit alle informatie in.
Wat we ontdekt hebben
En nu het stukje waar ik trots op ben. Afgelopen voorjaar hebben we een wetenschappelijk artikel gepubliceerd met een vondst die ik jullie graag uitleg.
Stel je voor dat een AI-model alle spraakklanken opslaat als punten op een enorme landkaart. Alle “m”-klanken liggen bij elkaar in een groepje. Alle “p”-klanken in een ander groepje. Bij een gezonde spreker liggen die groepjes ver uit elkaar, netjes gescheiden, met een duidelijke grens ertussen.
Wat wij ontdekten: bij dysartrie schuiven die groepjes naar elkaar toe en gaan ze door elkaar lopen. De grens vervaagt. En — dit is het belangrijke — hoe erger de dysartrie, hoe meer ze vervagen. Die vervaging kun je uitrekenen. Er komt gewoon een getal uit.
We hebben dat getest op 890 sprekers, uit tien verschillende onderzoeksverzamelingen, in vijf talen: Engels, Spaans, Nederlands, Mandarijn en Frans. Bij Parkinson, cerebrale parese én ALS. Het werkte overal.
Drie dingen die dit bijzonder maken:
- Het model hoeft niets te leren over zieke spraak. We kalibreren alleen op gezonde stemmen. Dat is essentieel, want opnames van dysartrische spraak zijn schaars — en in andere talen dan Engels bijna niet te vinden.
- Het werkt in talen waar het model nooit voor getraind is. Ons AI-model kende alleen Engels, maar herkende de achteruitgang net zo goed in Mandarijn. Blijkbaar zijn de fysieke mechanismen van spraak universeel genoeg.
- Het zegt wélk onderdeel achteruitgaat. Geen enkel cijfer, maar een profiel: is het je gehemelte, je stembanden, je tongbewegingen? Bij ALS blijkt de nasaliteit — de scheiding tussen “m/n” en “p/b/t” — vaak als eerste te verzwakken. Dat past precies bij wat artsen zien bij bulbaire ALS.
Wat betekent dat concreet? Dat je op een dag thuis, via je telefoon, een zin kunt inspreken en meteen weet of er iets verandert. Zonder wachtkamer. Zonder subjectief oordeel. En voor medicijnonderzoek is dit potentieel groot: als je achteruitgang veel eerder en preciezer kunt meten, kun je veel sneller zien of een medicijn werkt.
Wat er nog moet gebeuren (en waarom ik jullie nodig heb)
Nu de eerlijkheid, want ik ga jullie geen sprookje verkopen.
In dat onderzoek van 890 sprekers zaten precies vijf mensen met ALS waarvan we de ernst betrouwbaar wisten. Vijf. Van de 890. Alle mooie conclusies over ALS die ik hierboven noemde, zijn daarmee eigenlijk geen conclusies maar vermoedens. Goed onderbouwde vermoedens, maar meer niet.
Dat is niet omdat we lui zijn. Het is omdat opnames van ALS-spraak simpelweg nauwelijks bestaan. Zeker niet in het Nederlands. En al helemaal niet over tijd — dezelfde persoon, elke maand opnieuw, zodat je de verandering kunt volgen. Dat is precies wat we nodig hebben en precies wat er niet is.
Om van een veelbelovend idee naar iets te komen waar jij en ik daadwerkelijk iets aan hebben, is dit nodig:
- Veel meer opnames van mensen met ALS, in het Nederlands en andere talen dan Engels.
- Herhaalde opnames van dezelfde persoon, zodat we het verloop kunnen volgen in plaats van één momentopname.
- Opnames uit het echte leven, niet alleen uit een geluidsdichte studio. Want thuis, met de televisie aan en de kat op schoot, is waar het moet werken.
Wat we inmiddels gebouwd hebben
SMF VoxAI
SMF VoxAI — spraak in je eigen stem
Het eerste concrete product is SMF VoxAI, een webapp voor mensen met communicatiebeperkingen. Je logt in met een browser — geen dure apparatuur nodig. VoxAI helpt je sneller communiceren door mee te denken: het leert jouw manier van praten, jouw context, jouw mensen, en stelt antwoorden voor die klinken zoals jij klinkt. Gekoppeld aan je gekloonde ElevenLabs-stem hoor je vervolgens jezelf.
De achterliggende gedachte is dat een gesprek meer is dan woorden produceren. Als je twintig seconden nodig hebt om een zin te typen, is het gesprek al drie onderwerpen verder. VoxAI probeert die vertraging weg te nemen zodat je weer kunt meedoen in plaats van achteraan hobbelen.
Daarnaast is er dev.smfvox.ai, en dat is misschien nog wel belangrijker. Dat is ons ontwikkelaarsplatform: andere bedrijven en techneuten kunnen onze technologie daar ophalen en inbouwen in hún eigen toepassingen. Denk aan een fabrikant van spraakcomputers, een app-ontwikkelaar of een onderzoeksgroep.
Dat is een bewuste keuze. We hadden alles achter slot en grendel kunnen houden, maar dan bereiken we alleen de mensen die toevallig onze eigen app vinden. Door het open te stellen kan iedereen die iets goeds bouwt ermee verder. Precies wat Peter voor ogen had: technologie hoort niet opgesloten te zitten in dure, gesloten apparaten.
De CANDOR Recorder
En dan het tweede, waar deze blog eigenlijk om draait: de CANDOR Recorder. Een simpele app waarmee je thuis spraakopnames kunt maken voor het onderzoek. Je krijgt zinnen te zien, je spreekt ze in, klaar. Het duurt een paar minuten en je kunt het zo vaak herhalen als je wilt.
Elke opname die binnenkomt maakt het model beter. Niet in de verre toekomst — nu. Dit is geen onderzoek waarbij je gegevens in een la verdwijnen en er over tien jaar misschien iets mee gebeurt. Wat jullie inspreken gaat rechtstreeks het model in.
Uiteraard netjes geregeld: je gegevens worden geanonimiseerd, je audio wordt niet gedeeld of doorverkocht, alles volgt de AVG, en je kunt op elk moment stoppen.
Doe je mee?
Dit is mijn vraag aan jullie, en ik meen hem oprecht.
Wil je meedoen aan het CANDOR-onderzoek? Of je nu net gediagnosticeerd bent en je spraak nog helemaal in orde is, of je al langer moeite hebt met praten — beide zijn waardevol. Sterker nog: juist mensen die nog goed spreken zijn belangrijk, omdat we dan het verloop kunnen volgen vanaf het begin. Dat is precies de data die nu wereldwijd ontbreekt.
Ook partners, kinderen en anderen zonder spraakproblemen zijn welkom als vergelijkingsmateriaal. En heb je oude video’s of geluidsopnames van vroeger, van voordat je spraak veranderde? Die zijn goud waard.
Stuur me gewoon een mailtje op bernard@scottmorganfoundation.org en ik leg je persoonlijk uit hoe het werkt. Geen formulieren, geen gedoe. Gewoon een mailtje.
Tot slot. Peter Scott-Morgan zei dat een handicap een technisch probleem is dat je kunt oplossen. Ik geloof dat nog steeds. Maar technische problemen los je niet in je eentje op, en niet zonder de mensen om wie het gaat.
Wij zijn samen de enigen die precies weten wat er verloren gaat als je stem verdwijnt. Dat maakt ons geen slachtoffers van dit onderzoek, maar de belangrijkste deelnemers ervan.
Ik hoop van jullie te horen.
Tot de volgende keer. Volg mij op X voor het laatste nieuws.
Bernard Muller
